Una cebolla tiene un genoma aproximadamente cinco veces mayor que el suyo.
No cinco veces más genes: cinco veces más ADN. El pez pulmonado jaspeado tiene unas cuarenta veces más. Algunos helechos y amebas son todavía mayores. Mientras tanto, un pez globo se las arregla con aproximadamente un octavo de su genoma y es un vertebrado perfectamente funcional con esencialmente el mismo plan corporal.
Si cada par de bases estuviera haciendo un trabajo esencial, esto no tendría sentido. Una cebolla no es cinco veces más compleja que una persona. De ese hueco salió la expresión ADN basura, y la discusión sobre si la etiqueta fue acertada alguna vez.
Esta es la paradoja del valor C, y el biólogo evolutivo Ryan Gregory la convirtió en un reto conocido como la prueba de la cebolla: sea cual sea la función que proponga para todo ese ADN extra en los humanos, explique por qué una cebolla necesita cinco veces más.
Es la pregunta más difícil del debate sobre el ADN basura, y es la que casi nunca se aborda.
¿Qué es el ADN basura?
«ADN basura» se refiere a las porciones del genoma que no codifican proteínas y de las que durante mucho tiempo se supuso que carecían de función. El término lo acuñó el genetista Susumu Ohno en 1972.
Las proporciones son contundentes:
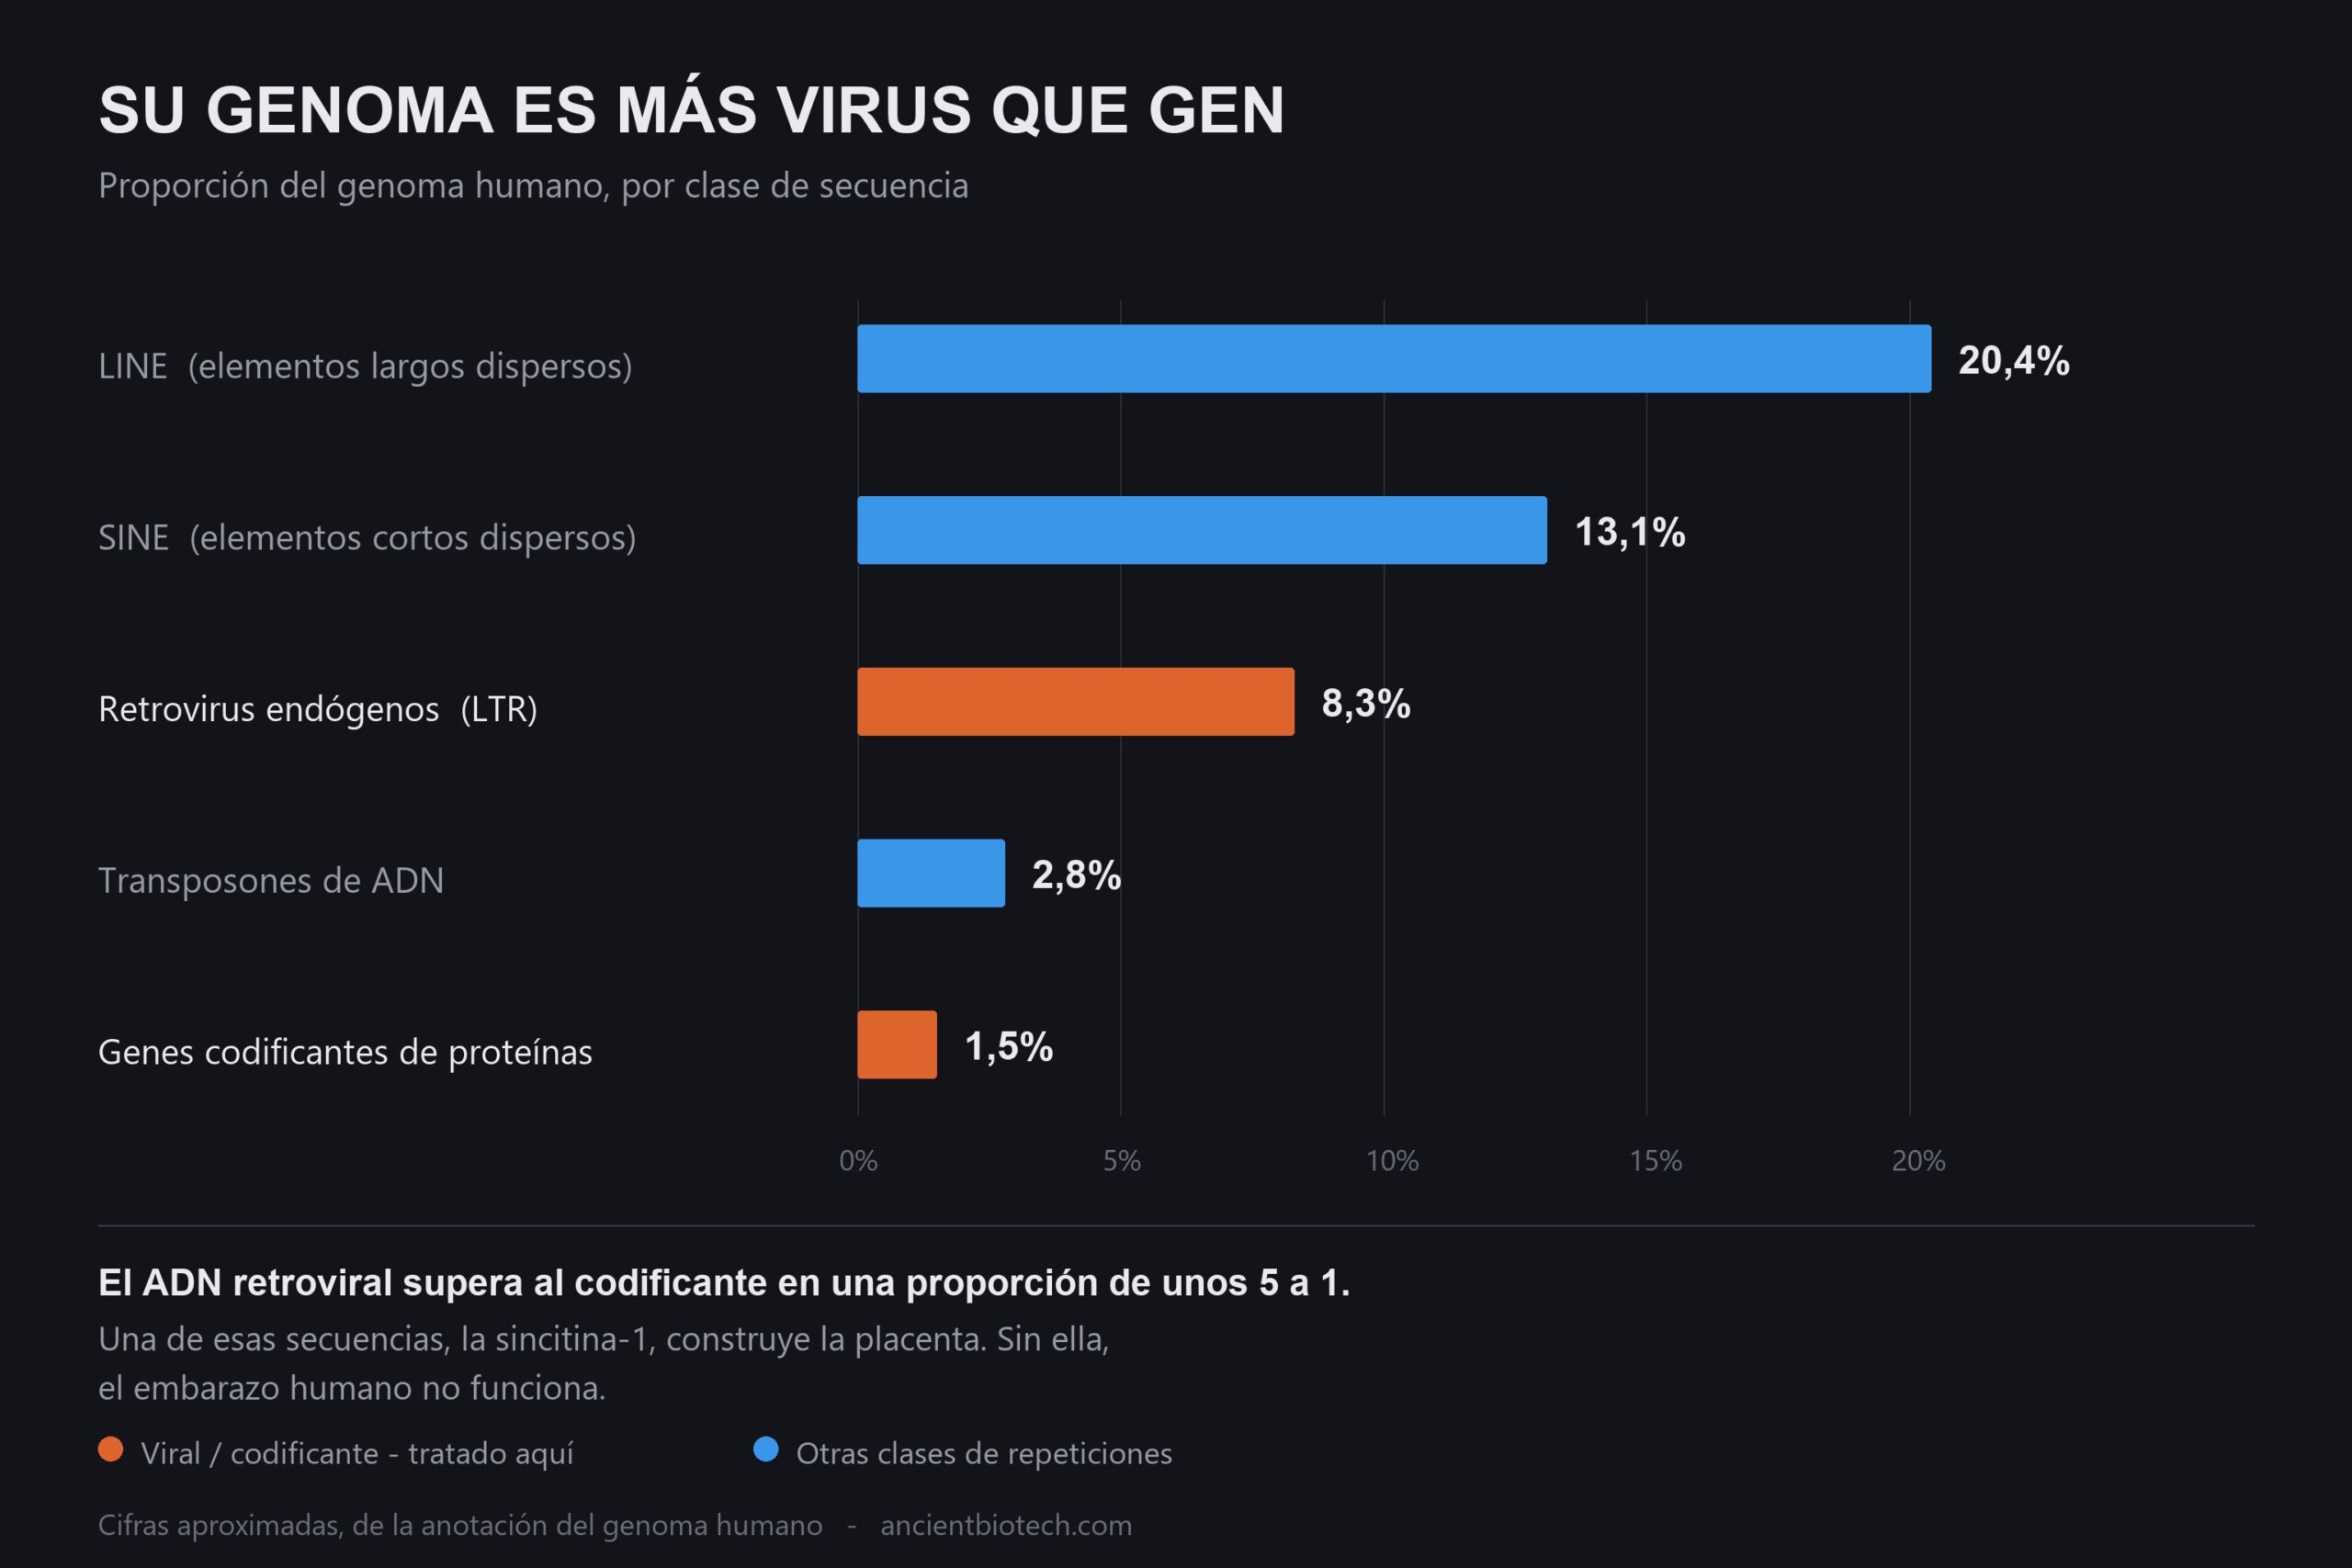
- Secuencia codificante de proteínas: alrededor del 1,5 % del genoma humano
- Elementos transponibles: cerca de la mitad — LINE, SINE, transposones de ADN
- Retrovirus endógenos: en torno al 8 % — secuencia de origen viral
- Seudogenes: miles de copias rotas de genes que antes funcionaban
- El resto: intrones, repeticiones, regiones reguladoras y grandes tramos de estatus poco claro
De modo que aproximadamente el 98,5 % de su genoma no codifica ninguna proteína. La pregunta es qué hace, si es que hace algo, en su lugar.
La pelea de ENCODE
En 2012, el consorcio ENCODE — un gran proyecto internacional que cartografía los elementos funcionales del genoma humano — publicó resultados anunciando que alrededor del 80 % del genoma es bioquímicamente funcional.
La cobertura de prensa fue inequívoca: el ADN basura ha muerto.
La reacción de los biólogos evolutivos fue inmediata y feroz, y la disputa giró enteramente en torno a una palabra.
ENCODE definió «funcional» como mostrar actividad bioquímica reproducible: ser transcrito a ARN, estar unido por una proteína o llevar una marca química concreta. Ese es un criterio técnico medible y defendible.
Los críticos argumentaron que era el criterio equivocado. Dan Graur y colaboradores publicaron una réplica cuyo título transmite la temperatura del intercambio, y la sustancia de la objeción era esta: la transcripción no es lo mismo que la función. Las células transcriben una gran cantidad de ARN que se degrada de inmediato. Las proteínas se unen al ADN de forma inespecífica a todas horas. Que una secuencia esté químicamente ocupada no significa que el organismo la necesite.
La analogía ofrecida: el motor de un coche produce calor y ruido. Ambas son salidas reproducibles. Ninguna es aquello para lo que sirve el motor.
El contraargumento de Graur usaba otra definición: la función por efecto seleccionado, según la cual una secuencia es funcional si la mantiene la selección natural, algo comprobable observando con qué fuerza se conserva entre especies. Con esa medida, la fracción del genoma humano bajo selección purificadora sale en torno al 8-15 %.
Dónde acabó realmente el campo
La respuesta honesta es que ambos extremos se equivocaron, y la resolución es genuinamente interesante.
Buena parte del ADN no codificante es definitivamente funcional. Esto no se discute y ya se sabía antes de ENCODE:
- Elementos reguladores. Promotores, potenciadores, silenciadores y aislantes controlan cuándo y dónde se expresan los genes. Los potenciadores pueden situarse a cientos de miles de bases del gen que regulan.
- ARN no codificantes. Los microARN regulan la traducción. Los ARN largos no codificantes hacen muchas cosas: XIST, que silencia uno de los cromosomas X en las hembras, es un ARN largo no codificante y es absolutamente esencial.
- Secuencia estructural. Los telómeros cubren los extremos de los cromosomas; los centrómeros son donde se anclan las fibras del huso. Ninguno codifica proteína; ambos son indispensables.
- Intrones. Se eliminan de los transcritos, pero permiten el ayuste alternativo — un gen que produce múltiples proteínas —, que es una fuente importante de la complejidad proteómica humana.
Y buena parte casi con seguridad no lo es. Millones de copias de elementos transponibles degradados, seudogenes que acumulan mutaciones sin consecuencia y extensiones enormes de repeticiones cuya cantidad varía muchísimo entre especies estrechamente emparentadas. La prueba de la cebolla se aplica aquí con toda su fuerza.
El consenso actual, a grandes rasgos: el genoma no es mayoritariamente basura, y no es mayoritariamente funcional. Una minoría sustancial hace un trabajo identificable, una fracción sustancial es inerte, y la frontera está sin resolver y depende de qué definición de «función» se adopte.
Por qué el genoma tiene este aspecto
La pregunta más útil no es cuánto es basura sino por qué un genoma acumularía tanto de ello.
Los elementos transponibles son la respuesta principal, y son esencialmente parásitos genómicos. Un retrotransposón se copia a sí mismo e inserta la copia en otro lugar. Eso sirve a la propagación del elemento, no al organismo. La mayoría de las copias se degradan con el tiempo hasta convertirse en secuencia inerte, pero no se eliminan, porque la deleción no es automática.
Que se acumulen o no depende del tamaño de la población. En poblaciones grandes, la selección es eficiente y las inserciones ligeramente deletéreas se eliminan. En poblaciones pequeñas domina la deriva genética y una secuencia levemente dañina puede fijarse por azar. Es el argumento de Michael Lynch: los genomas grandes son en parte consecuencia de un tamaño poblacional efectivo pequeño más que un logro funcional.
Ese marco predice exactamente el patrón observado: bacterias bajo selección intensa con genomas compactos, y eucariotas multicelulares con poblaciones pequeñas cargando cantidades enormes de secuencia repetitiva.
¿Plano o archivo?
El encuadre persistente presenta el ADN como un plano o un programa, y mucha de la confusión viene de esa imagen.
Un plano no tiene líneas desperdiciadas. Un programa no tiene código muerto que persista cien millones de años. Ambos están diseñados, y el diseño implica eficiencia.
Un genoma no está diseñado y no se comporta así. Se entiende mejor como un archivo que nunca ha sido curado: capas de secuencia funcional, secuencia obsoleta, inserciones virales que fueron domesticadas para funciones esenciales, inserciones virales que nunca fueron útiles, duplicaciones, copias rotas y repeticiones — todo acumulado a lo largo de miles de millones de años, con eliminaciones que ocurren solo cuando ocurren.
Ese encuadre también da sentido a los hallazgos genuinamente notables. La sincitina, el gen de envoltura retroviral que construye la placenta, es exactamente lo que produce un archivo sin curar: llega un parásito, la mayoría de las copias se degradan y de vez en cuando una se reaprovecha para algo sin lo que el organismo no puede vivir.
Eso no se obtiene de un plano. Se obtiene de la acumulación más la selección actuando sobre lo que haya por ahí.
Qué costó la etiqueta
El término de Ohno hizo un daño real, y merece señalarse.
Durante décadas, las regiones no codificantes se estudiaron poco porque el nombre señalaba que no merecían estudio. El esfuerzo investigador se concentró en el 1,5 % que fabricaba proteínas. Cuando resultó que la secuencia reguladora importaba enormemente — y cuando los estudios de asociación de genoma completo hallaron que la gran mayoría de las variantes ligadas a enfermedad caen fuera de las regiones codificantes —, el campo tuvo que volver a mirar un territorio que había etiquetado como desecho.
Es una lección sobre los nombres. Llamar basura a algo es una afirmación sobre su función, hecha antes de conocer la función, y es muy eficaz impidiendo que nadie lo compruebe.
Es el mismo fallo que leyó los clastos de cal romanos como mezcla chapucera durante un siglo, y que archivó Göbekli Tepe como cementerio medieval durante treinta años. La observación se registró con exactitud. La etiqueta que se le puso impidió que nadie volviera a mirar.
Preguntas frecuentes
¿Qué es el ADN basura?
Porciones del genoma que no codifican proteínas y de las que se supuso que carecían de función. El término lo acuñó Susumu Ohno en 1972. Alrededor del 98,5 % del ADN humano no codifica proteína.
¿Es realmente basura el ADN basura?
En parte. Mucho ADN no codificante tiene funciones identificadas: elementos reguladores, ARN no codificantes, telómeros, centrómeros e intrones. Una fracción grande, en particular los elementos transponibles degradados y los seudogenes, no muestra evidencia de función.
¿Qué halló el proyecto ENCODE?
ENCODE informó en 2012 de que alrededor del 80 % del genoma es bioquímicamente funcional, definiendo la función como mostrar actividad bioquímica reproducible, como ser transcrito o estar unido a proteínas. Los críticos alegaron que eso confunde actividad con función.
¿Qué porcentaje del genoma humano es funcional?
Depende de la definición. Por actividad bioquímica, la cifra de ENCODE fue de alrededor del 80 %. Por función de efecto seleccionado — secuencia conservada por la selección natural entre especies —, las estimaciones se sitúan en torno al 8-15 %.
¿Qué es la prueba de la cebolla?
Un reto planteado por Ryan Gregory: puesto que el genoma de la cebolla es unas cinco veces mayor que el humano, toda función propuesta para nuestro ADN no codificante debe explicar además por qué una cebolla necesita cinco veces más.
¿Por qué algunos organismos tienen genomas mucho mayores que los humanos?
En gran medida por la acumulación de elementos transponibles, influida por el tamaño poblacional efectivo. En poblaciones pequeñas, la deriva genética permite que persistan inserciones levemente deletéreas, mientras que las poblaciones grandes las eliminan con más eficacia.
¿Qué porcentaje del ADN humano codifica proteínas?
Alrededor del 1,5 %. Los elementos transponibles suponen cerca de la mitad, los retrovirus endógenos en torno al 8 %, y el resto lo forman intrones, secuencia reguladora, seudogenes y repeticiones.
¿Dónde se encuentran las variantes genéticas ligadas a enfermedades?
La gran mayoría de las variantes identificadas por los estudios de asociación de genoma completo caen fuera de las regiones codificantes de proteínas, en secuencia que antes se descartaba como basura.
La cebolla sigue sin respuesta
La pregunta «¿cuánto del genoma es basura?» ha consumido una cantidad enorme de discusión, y puede que sea la pregunta equivocada.
Su genoma no es un documento que alguien escribiera. Es un depósito: cuatro mil millones de años de secuencia acumulada, sin editor, sin control de versiones y sin política de borrado. Inserciones virales junto a genes a los que después fueron reclutadas para servir. Copias rotas de genes funcionales junto a los originales funcionales. La mitad consiste en elementos que se copiaron ahí por sus propias razones.
Parte de eso se recogió y se puso a trabajar, y un fragmento así construye el órgano en el que usted creció. La mayor parte no, y simplemente se quedó, porque nada la retira.
Una cebolla tiene cinco veces más. Nadie ha explicado por qué, y hasta que alguien lo haga, toda afirmación segura sobre para qué sirve el otro 98,5 % va por delante de la evidencia exactamente como iba la palabra «basura» en la dirección contraria.
Seguir leyendo
- El código secuestrado: su placenta la construyó un virus — El ocho por ciento de su genoma es retroviral. Los genes codificantes son el 1,5 %. La proteína que construye la…
- Por qué tenemos 46 cromosomas y los simios 48 — Usted tiene 46 cromosomas. Todos los demás grandes simios tienen 48. Qué hay en 2q13, el caso en contra de leerlo como…
- La Sábana Santa de Turín: un negativo que nadie encargó — El polvo aspirado del lienzo en 1978 ya ha sido secuenciado, y el resultado se contó como prueba de que la Sábana vino…